ppt-kit · 幻灯片逆向还原
解决什么问题
手上有三类幻灯片,共同点是都改不了。
AI 生成的整页位图,Midjourney、各类 AI PPT 工具出的图。别人发来的 PDF,源文件早没了,可能是 NotebookLM、Canva 或 Keynote 导出的讲义。还有图片版 PPTX,用 PowerPoint「另存为图片演示文稿」导出的那种,内容全压平在一张图里。
传统办法都不好使。在线转换器有数据外泄风险,排版容易错乱,字体还可能被偷换。转成图再 OCR,一个字一个字地认,错别字和标点丢失几乎躲不掉,文字背后还留一片模糊残影。
ppt-kit 的做法是把结构重新推出来。它给你真正的文本框、原生的圆角矩形和胶囊、独立的透明配图层。拿到手能双击改字、能改填充色、能单独拖走一个图标。
核心功能
能读的绝不识别。 PowerPoint、Keynote、NotebookLM 导出的矢量 PDF 里有完整的文字流和坐标,直接解析。字符准确率 100%,字号误差 0.0pt,颜色误差 ΔE = 0.0,单页 0.4 秒。
位图多图层重建。 大卡片、分区框、标题胶囊、连接线识别为 PPT 原生形状。插图与 Logo 抠成独立透明 PNG 浮层。文字与图元区域分级背景修复,原位抹除不留残影。
原生表格逆向。 检测规整表格并重建为 PowerPoint 原生 Table,保留单元格文字、行列跨度与对齐。圆角卡片和流程图不会被误判成表格。
纯图片版 PPTX 无损解包。 直接把 .pptx 当输入,从 OpenXML 媒体库里取出原始高清图,毫秒级完成,没有二次重采样。
本地 Web 工作台。 拖进去就转,多页流式进度,原图与结果可拖动的对比滑杆,低置信元素的边界框热力图,一键下载 PPTX 和 JSON 报告。
跨页母版归纳与体积优化。 多页共用的页眉 Logo 抽到母版层,相同底图在文件里只存一份,实测体积缩八成以上。
质量报告可编程。 每页记录 SSIM、可编辑元素数、降级元素、低置信清单、耗时。--json 模式下 stdout 只出纯数据,方便接自动化流水线筛选复核页。
100% 本地离线。 macOS 走 Apple Vision,Windows 与 Linux 走内置的 RapidOCR,模型和计算都不出本机。
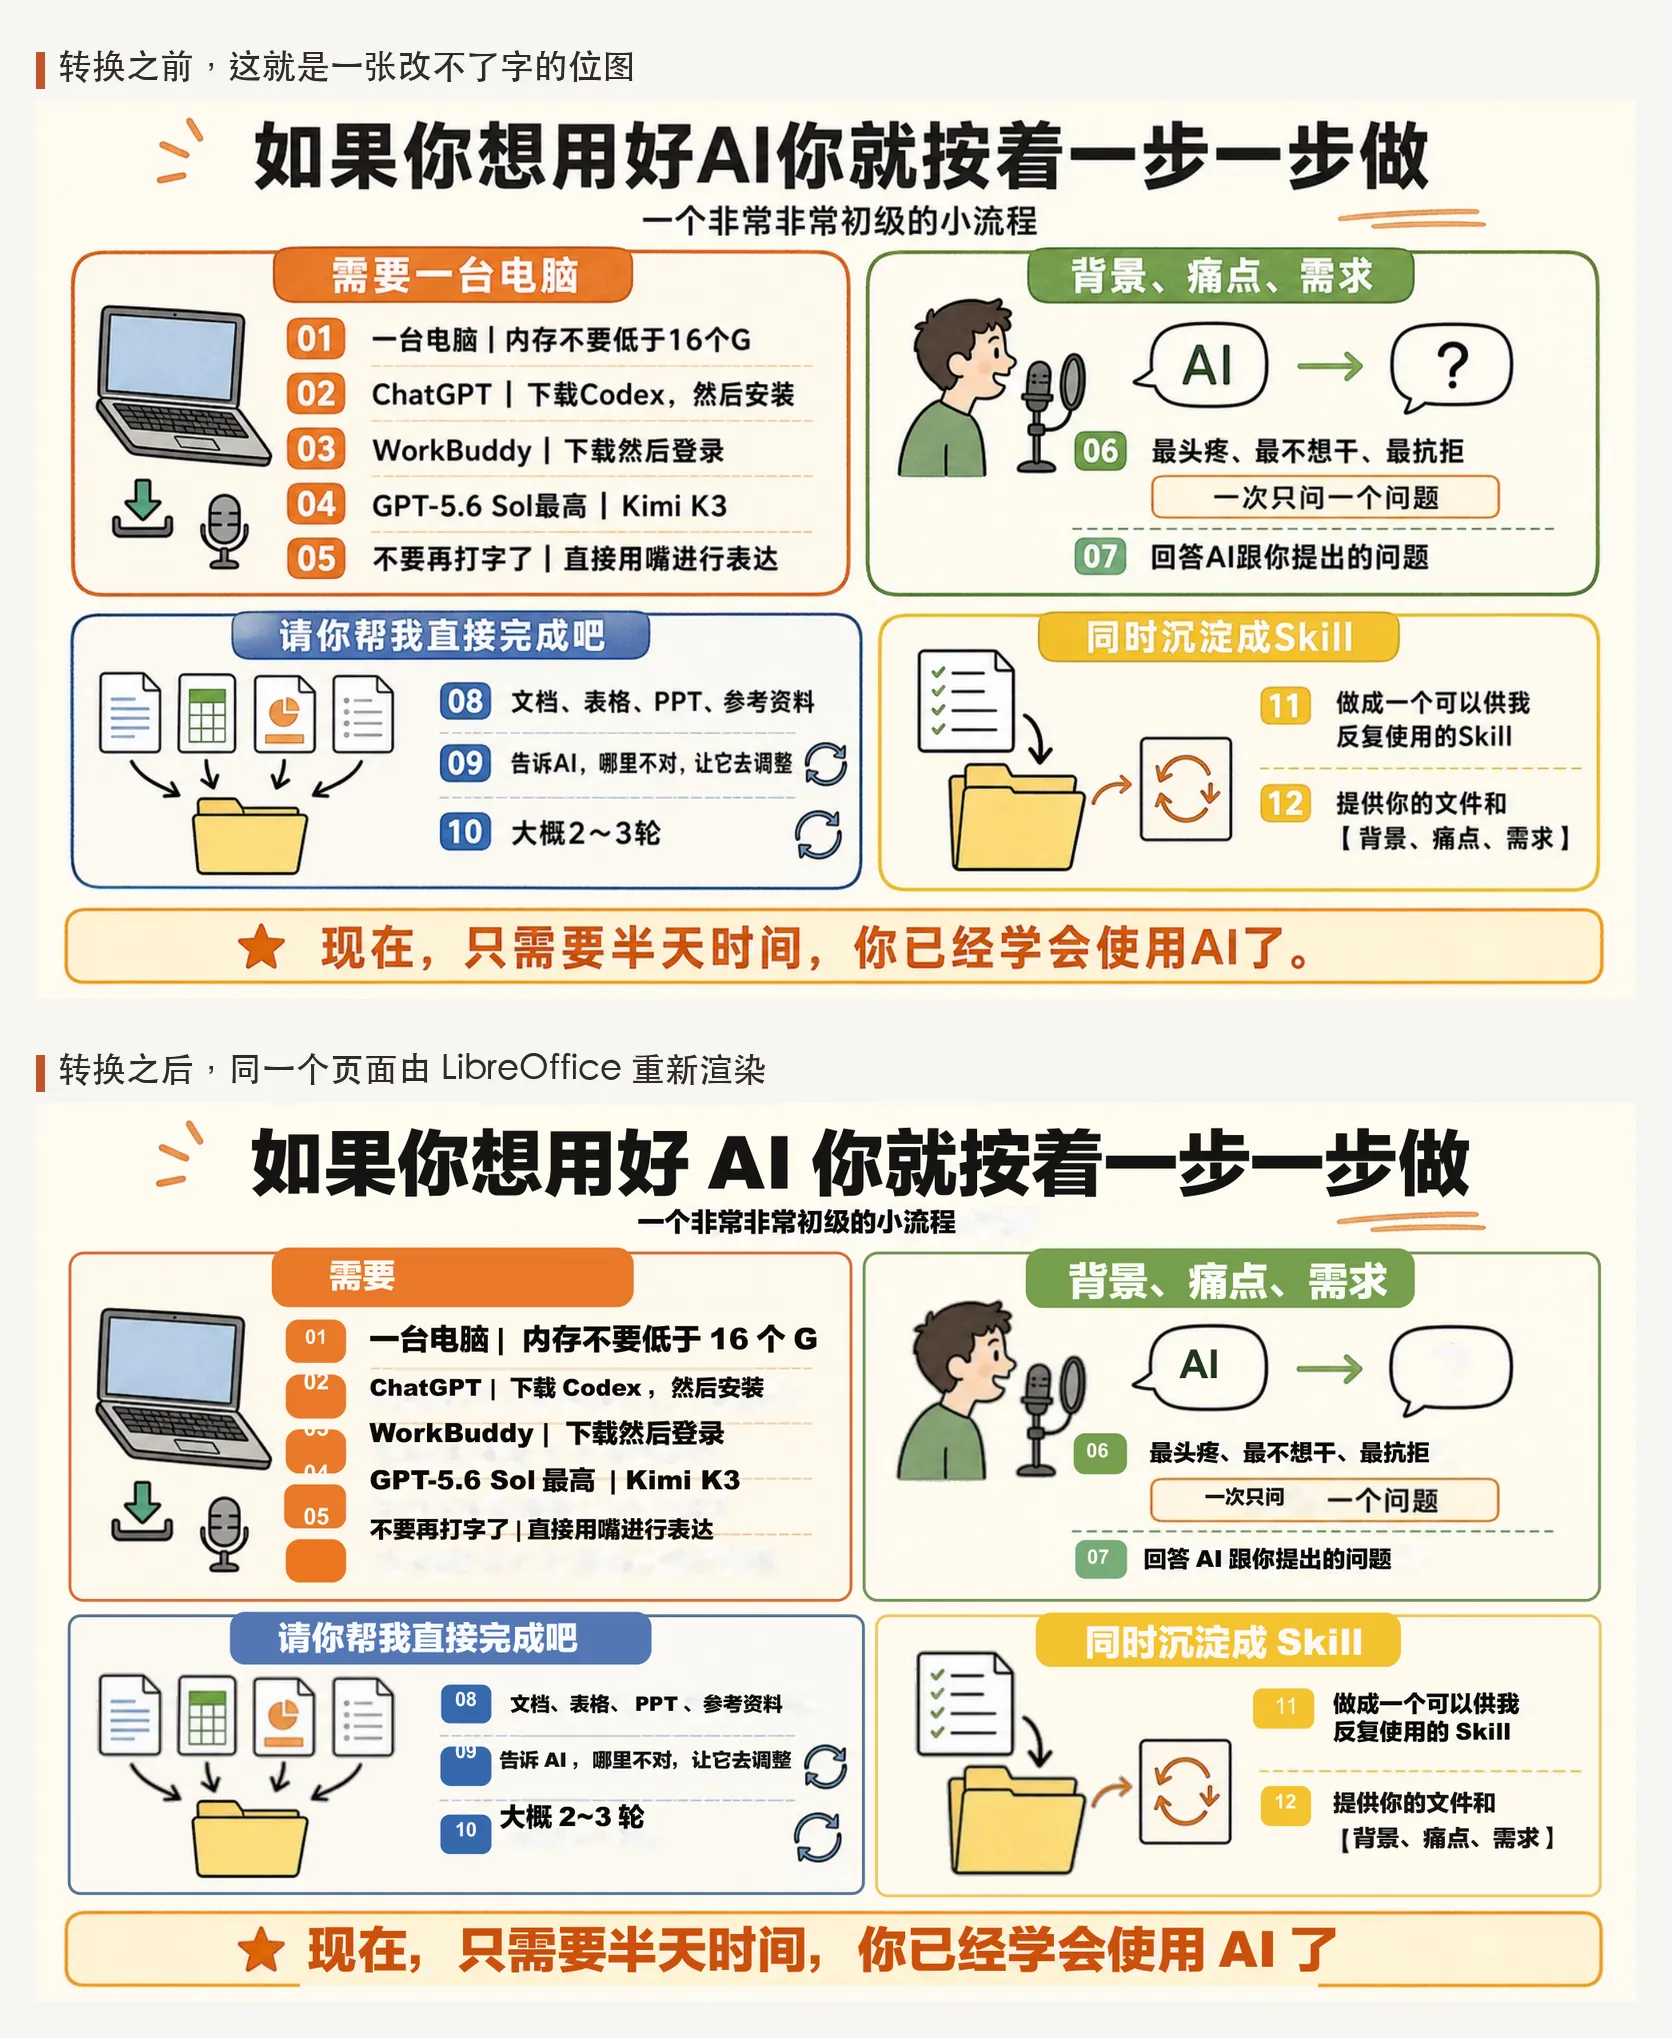
上面是原始位图,下面是还原出来的 PPTX 用 LibreOffice 重新渲染的结果。这一页 SSIM 0.689,提出 68 个可编辑元素,全程零云端调用。
设计原则
能读就不识别。 输入里存在矢量信息时直接解析,OCR 只用于真正的位图。
统一中间表示。 所有输入先转成 Slide IR,PPTX 生成器只认这个中间层。
质量靠度量。 每次转换都由原生渲染器输出像素级报告,不靠肉眼判断。
宁可退化,不可错乱。 拿不准的复杂图元降级为高清图片层,保留原样,绝不生成位置错乱的可编辑对象。
怎么获取
独立可执行包不用装 Python,解压即跑。Releases 页有 macOS arm64、Windows x86_64 和 Linux x86_64 版本。也可以 uv tool install git+https://github.com/monkeychen/ppt-kit.git 装命令行。
pptkit convert sample.pdf -o out/      # 转换一个文件
pptkit convert ./slides_dir/ -o out/   # 批量转换整个目录
pptkit gui                             # 启动本地 Web 工作台

# 只挑出需要人工复核的页面
pptkit report out/sample.report.json --needs-review --ssim-threshold 0.85
设计边界(明说在前)
不承诺像素级 100% 还原。 AI 生成的图本身没有原始字体和原始数据,像素级完全一致做不到。项目用 SSIM 和可编辑元素占比两个可测指标代替,每页报告写着实际数字。
不把复杂插画强行矢量化。 立体机房、多层拓扑沙盘这类东西保持为高清透明 PNG,硬拆成基础几何块只会更糟。
复杂版式仍需人工审一遍。 定位是从「重画二十页」压到「修三页」,不是一键交付。
v0.4.0 仍在推进。 四页竞聘稿的验收线是平均 SSIM 从 0.62 提到 0.82,还没走完发版。