我把一张改不了字的幻灯片,拆回成了能改的 PPT
我手上有一份七十五页的培训稿,是用 AI 生成的图片型幻灯片。暖白底,信息图排版,每页右上角一个 logo。放在投影上看很好看。
它的麻烦在于改不了。整页在 PowerPoint 里就是一张位图,正文、标题、图标、色块全压平在里头。改一个错字,只有两条路。整页重画,或者重新让 AI 生成一版。重画意味着原来那版构图没了,重新生成意味着后面几十页的风格跟着漂。
这不是我一个人的处境。AI 生成的图、别人发来的 PDF、图片版 PPTX,现在到处都是,而它们共同的特点就是改不了。
十月十九号我把这件事立成了项目,给一张位图,要一份改得动字的 PPTX。
项目叫 ppt-kit。
为什么这件事比看上去难
PPTX 是个有结构的文件。一句话在它里面是文本框,框里有段落,段落里有文字片段,每一段带着字号、字重、颜色、行距、对齐方式。它还有个坐标,单位是 EMU,1 英寸等于 914400 个 EMU。
位图里没有这些。只有像素。哪个像素属于字,哪个属于框,字多大,什么颜色,全靠猜。
这件事没法叫转换。转换意味着结构还在,换个容器装一下。这里结构全丢了,你手上只剩一张图,得把文本框、形状、字号、颜色一样一样重新推出来。推错一步,用户拿到的就是一堆看着像但一碰就散的碎玻璃。
这个判断决定了整个项目的形状。
能读的绝不猜
最开始我以为只有一条路,OCR。后来发现手上有相当一部分输入根本不是位图。
PowerPoint 和 Keynote 导出的 PDF,里面是有文字流的。每个字符的编码、字体、字号、颜色、精确坐标,全都躺在文件里,只是被压平成了页面。NotebookLM 导出的 PDF 也属于这一类。
对这些文件做 OCR,等于先把能读的东西翻译成图,再猜回来。多绕一圈,还多损失一次。
所以 ppt-kit 的第一条原则就是,只要输入里有矢量信息,就直接解析,不走识别。
这条路段的成绩是这样。字符准确率 100%,字号误差 0.0pt,颜色误差 ΔE = 0.0,单页 0.4 秒。数字好看得不像真的,因为它压根不需要识别,读出来是什么就是什么。
代价是这条路只能吃矢量 PDF。真正的硬骨头在位图那边。
位图那条路,脏得多
我把能找到的这类幻灯片都收进了一个测试集,先是七张不同风格的真实信息图,后来加进来三套完整稿子,四页的、十页的、七十五页的,加起来九十六页。
跑第一张就出事了。
那是一张十二步流程的信息图,每步一个彩色胶囊编号。还原出来的 PPT 里,编号 07 那个绿色胶囊被抹成了白色,字号比原图大了一圈。11 号那个黄色胶囊里的白字,被认成了黄色字,白字压在黄底上,等于没字。
我去看为什么。07 上面有一条绿色虚线,Apple Vision 把它和下面的文字框在了一起,检测框高度从 40 像素变成了 69 像素。抹除算法按整个框涂抹,绿色胶囊就跟着进去了。字号是按框高估的,框高多了 70%,字号就大了 15%。
这类问题没有尽头。你把一个修好,下一个从别的地方冒出来。
后面几周踩的坑,我记在项目仓库的踩坑日志里,一条一条都写着现象、原因、怎么改的。挑几个说说。
一张卡片被认成了右箭头。因为它的轮廓在某处有个小突起,分类器只看局部峰值,看形状不看比例。后来加了一条硬规矩,填充率超过 0.80 的大矩形一律排除箭头。
齿轮图标内部被 OCR 认出一个「¢」。因为图标的高对比度边缘在卷积核眼里和文字笔画长得差不多。后来按重叠区域和字符长度把这些伪字符剥掉,同时保护大于 22pt 的真标号,那是正常的页码。
带标题栏的圆角卡片被整张判成了表格,抹白改成六列,里面的流程文字被切成竖排的面条字。这个最伤。后来加了四道门禁,其中一道是「一票否决」,只要有任何一行文字被推断出来的列线从中间劈开,立刻放弃表格判定。
还有一个更隐蔽的。多页文档转换时,程序觉得第 1 页和第 3 页底色都是白,就把第 1 页的底图直接给了第 3 页。结果第 1 页底部那条深蓝箭头,被印到了第 3、4 页,盖在正文上。原因是它用 32×18 的缩略图算平均差,而两页 85% 的面积都是白的,一条横幅在那点面积里根本拉不动平均值。后来改成按网格分块比,只要有任何一块局部色差超过 8,就不许共享底图。
这些细节单看都很小。堆在一起就是一件事,位图还原的精度由上百个这样的判断共同决定,没有哪个模型能一次把它们全给对。
我自己测了一遍
写这篇文章之前,我又跑了一次。用测试集里的那张 AI 入门流程图,一张 2068×1162 的位图,走位图路径。
结果是这样的。SSIM 0.689,从图里提出 68 个可编辑元素,没有一个是降级的,耗时 22.3 秒。全程不联网,没有调用任何云端模型,OCR 在本机跑。
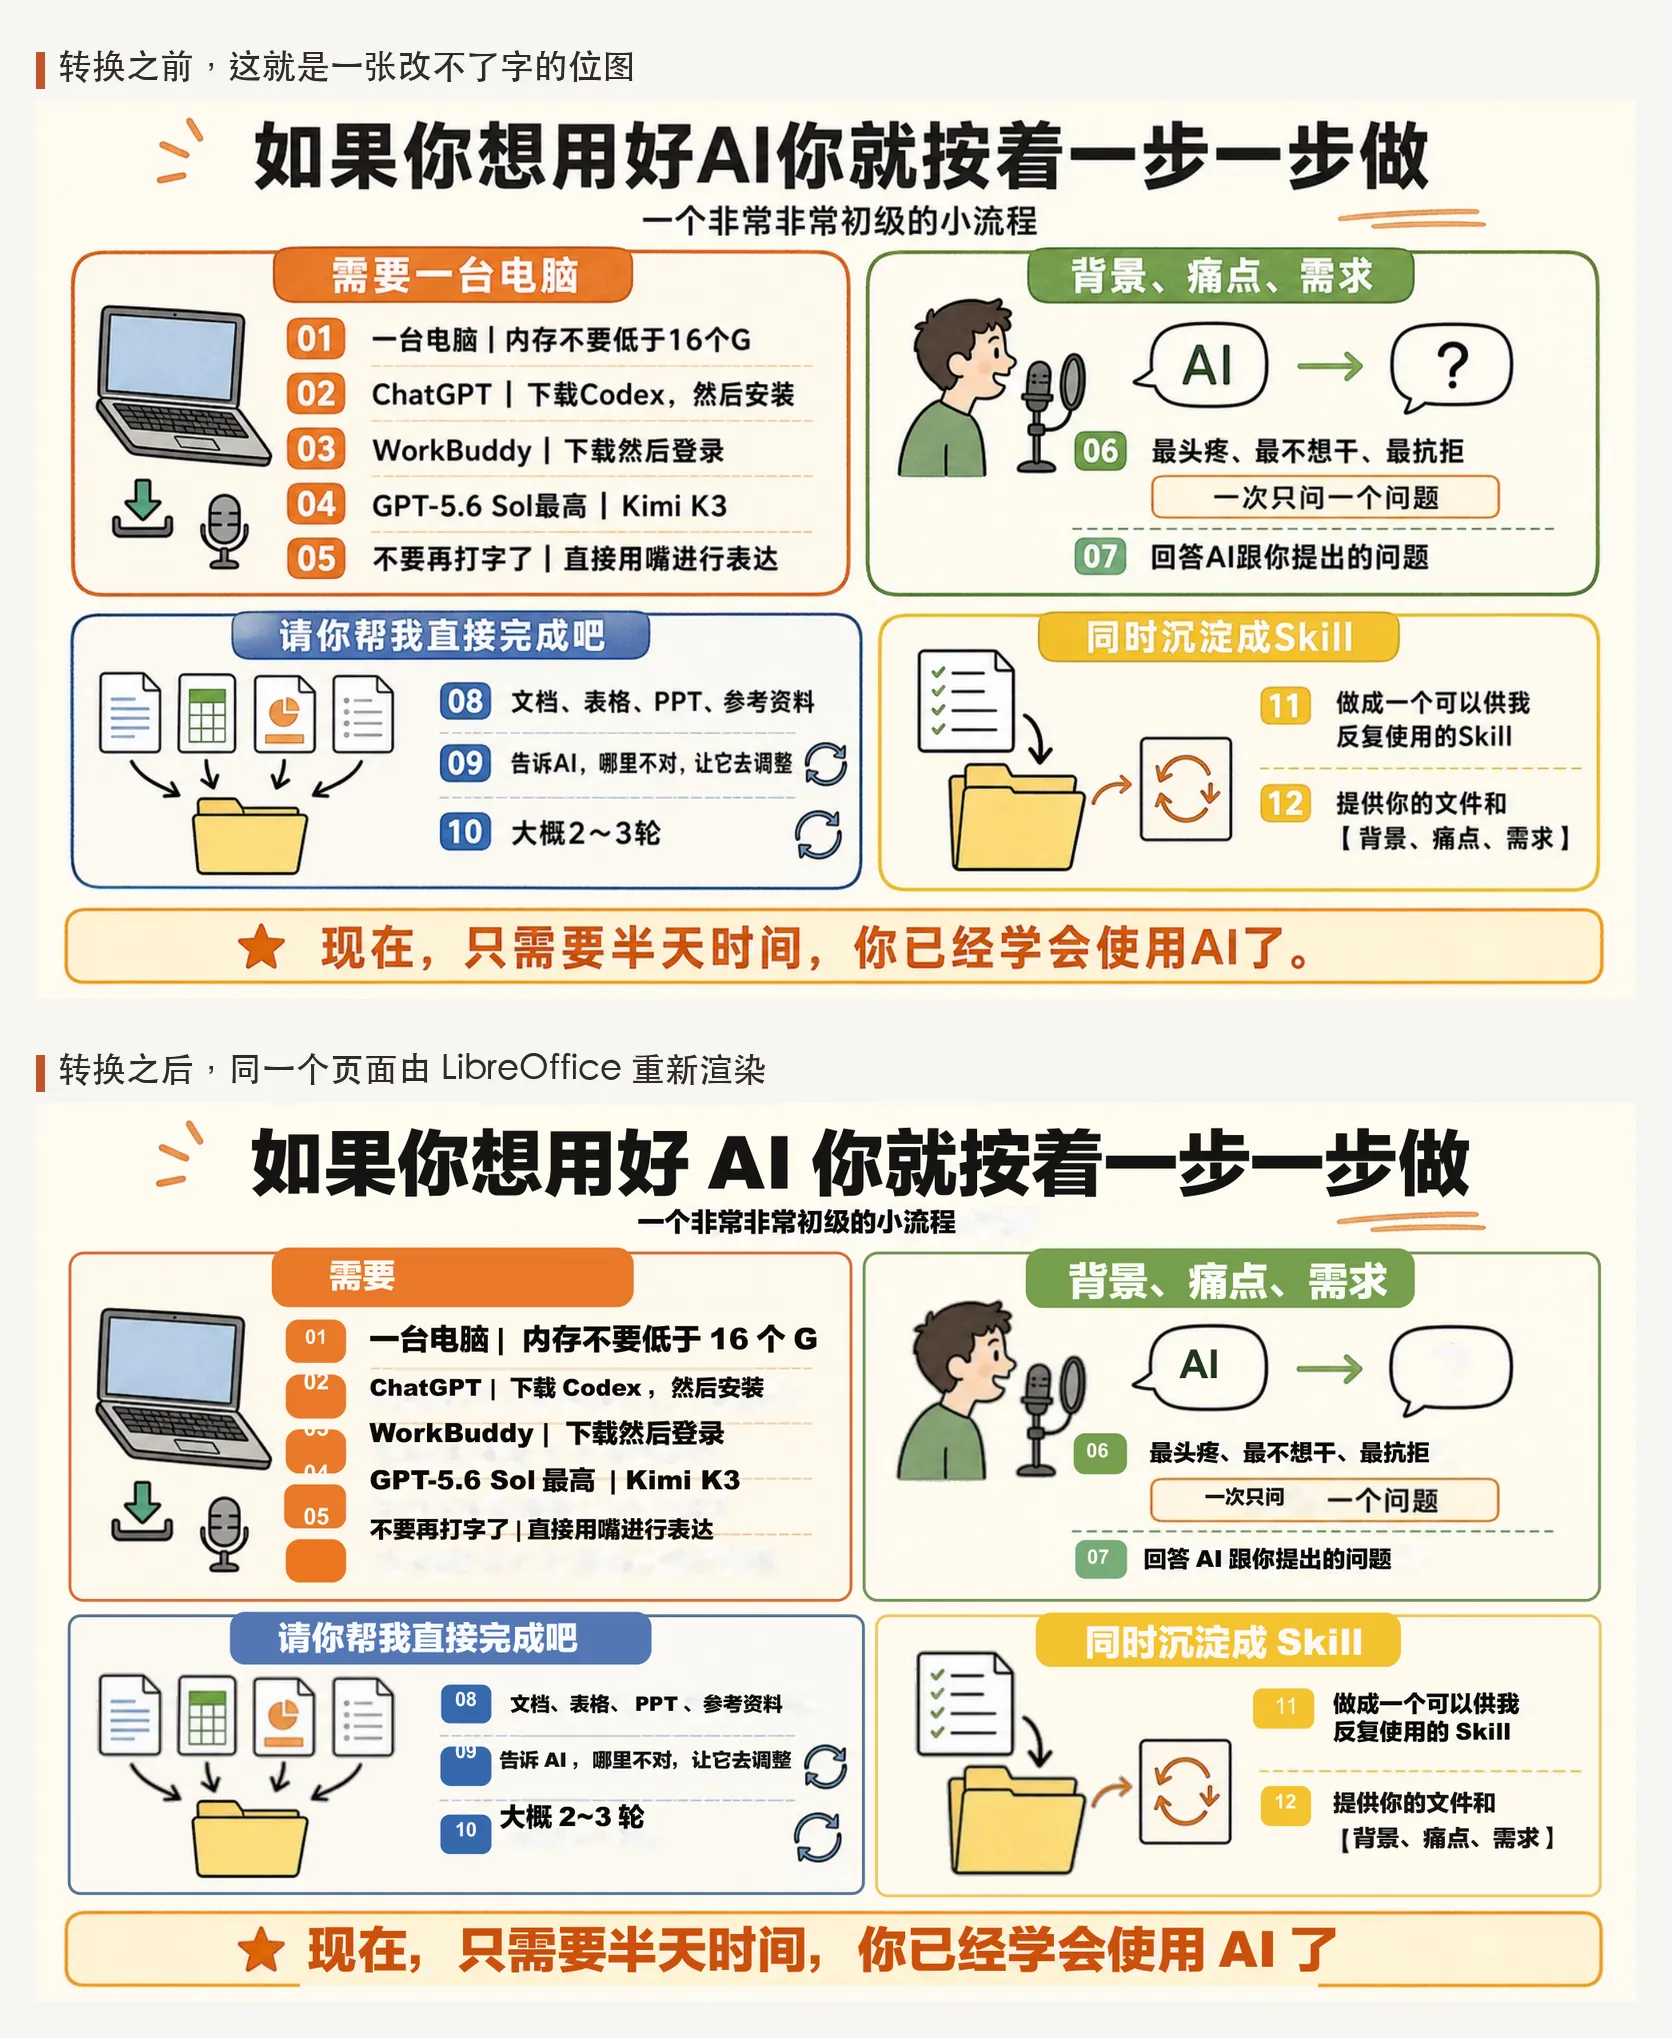
图里上面是原图,下面是还原出来的 PPTX 用 LibreOffice 重新渲染的结果。这张图特意用 LibreOffice 渲染,我这台机器的 PowerPoint 被 macOS 沙盒挡住了 AppleScript 导出,反倒是 LibreOffice 能老实把文件渲出来。对读者来说这也更好,它顺便证明了生成的文件换个软件照样能打开。
SSIM 0.689 这个数字,说实话不好看。0.69 的意思是两张图结构上约七成一致。人眼看,文字都在、位置都对、颜色都对,但就是能察觉哪里不太一样。
这个差别落在哪,我也知道。文字边缘的渲染细节,形状的圆角弧度,还有几个我没抠干净的边角。
我不想把话说得比实际好。这东西现在能替你做的事和不能替你做的事,界线挺清楚的。
能拿它干什么
第一种情况,你手上有 AI 生成的幻灯片,要改里面的字。这是最典型的场景,也是我自己开始做这个项目的场景。转换完,你能双击进去改文字、换品牌色、删掉不想要的一行,不用整页重画。
第二种,别人发你一个 PDF,你要拿回来当模板用。矢量 PDF 走那条 0.4 秒的路,字符一个不差,你拿到的几乎就是原始文件。
第三种,培训讲师手上有一堆 NotebookLM 生成的课件 PDF,想改成自己的东西。
第四种,自动化流水线。这条是给写代码的人准备的。命令行支持整个目录批量跑,跑完输出一份 JSON 质量报告,每页记录 SSIM、可编辑元素数、低置信元素清单、耗时。你可以写个脚本,把 SSIM 低于 0.85 的页挑出来人工复核,剩下的直接过。
它不该被用在什么地方,我也说清楚。你要做一份对外发布的精品,转换出来的东西还是得自己审一遍。它的定位是把你从「重画二十页」压到「修三页」。
有个原则我一直守着
项目文档里有一条被反复引用的原则,宁可退化,不可错乱。
意思是,当某个元素我拿不准它到底是什么、该放哪,就不要硬猜。把它降级成一张高清透明图,保留原样。用户拿到的 PPT 里,那个东西还是能看,只是不能改字。这比给他一个位置错乱、内容还带着错别字的文本框好得多。
这条原则让不少功能「看起来没做完」。但它换来的是另一件事,你转换出来的东西不会有那种让人火大的意外。
现在到哪一步了
从开工到现在,七十五次提交,五个版本。
v0.1.0 把两条主路径和度量系统立起来,矢量解析、位图分层、SSIM 报告。v0.2.0 补了原生表格的逆向重建,加上了跨平台 OCR 适配,在 macOS 走 Apple Vision,Windows 和 Linux 走 RapidOCR。v0.3.0 做了本地 Web 工作台,拖进去就能转,左边原图右边结果,中间一条可拖动的对比滑杆,还能看低置信元素的热力图。v0.3.1 解决了一批「看起来能用但用起来难受」的问题,最明显的是把一页里七十多个碎文本框合并成了十几个语义卡片,改字时会自动折行,拖卡片时不会散架。
多页文档另外还做了两件事。一是自动归纳母版,把跨页共用的页眉 Logo 抽到母版层。二是媒体流去重,十页共用同一张底图时,文件里只存一份。实测体积缩了八成以上。
v0.4.0 的验收线是拿四页竞聘稿把平均 SSIM 从 0.62 提到 0.82。要改的全是细活。标题左边的装饰竖条不能被当成乱码抹掉。胶囊里的小图标得保住图形,旁边的文字得干净。同一段话的多行不能第一行 14pt、第三行 16pt 还加粗。没有一条能靠换模型解决。
这一版两块活,M1 管版面不崩,跨页母版、表格误判、巨幅图层挡点击;M2 管图文剥离和排版统一。代码都过了,还差最后打磨和发版。
装一个试试
macOS、Windows、Linux 都有打包好的独立程序,不用装 Python,解压就能跑。
# 转换一个文件
pptkit convert sample.pdf -o out/

# 启动本地工作台,会自动开浏览器
pptkit gui
项目在 https://github.com/monkeychen/ppt-kit ,MIT 许可,商用和二开都行。安装包在 Releases 页,最新是 v0.3.1。
现在这个阶段,我最想知道的是它在别人手上的真实表现。尤其 Windows 那边,我只在一台机器上验过,字体缺失、路径编码、OCR 引擎的差异,这些坑得有人真用了才会浮出来。遇到问题请提 issue,把原图和输出一起放上去,我一看就知道该改哪里。
那七十五页的稿子,我等着它能跑稳了再动。